구글·앤스로픽·OpenAI 재단 등 참여
5년간 소외 언어 데이터·평가체계 공동 구축
데이터 소유권·당사자 동의가 핵심 쟁점
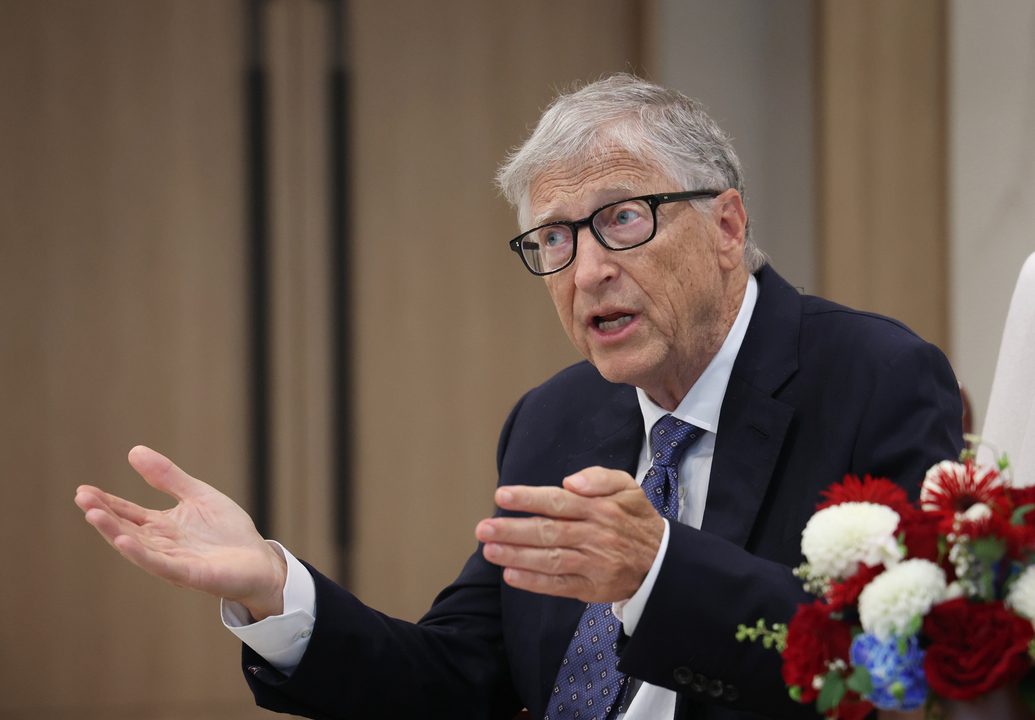
게이츠재단이 구글·앤스로픽·OpenAI 재단 등 60개 기관과 함께 인공지능(AI)의 ‘언어 격차’를 줄이기 위한 국제 연합체를 출범시켰다. 영어 등 일부 언어에 집중된 AI 생태계를 확장해, 앞으로 5년간 소외 언어 사용자 약 34억명이 자신의 언어와 목소리로 AI를 이용하도록 돕겠다는 목표다.
게이츠재단은 최근 AI 개발사와 기업, 정부기관, 연구기관, 비영리단체, 자선재단 등이 참여하는 공동 이니셔티브를 발표했다. 앤스로픽과 구글, OpenAI 재단을 비롯해 모질라 데이터 컬렉티브 등이 초기 참여기관으로 이름을 올렸다.
현재 세계에서 사용되는 언어는 약 7000개지만, 충분한 학습 데이터와 성능 평가체계를 갖춰 AI가 안정적으로 지원할 수 있는 언어는 일부에 불과하다. 인터넷상 자료가 적은 ‘저자원 언어’는 AI가 문맥이나 방언, 관용어, 문화적 의미를 제대로 이해하지 못해 번역 오류와 정보 격차를 일으킬 가능성이 크다.
특히 의료·교육·농업처럼 정확성이 중요한 분야에서는 언어 오류가 실제 피해로 이어질 수 있다. 게이츠재단은 말라위 임신부가 현지어로 “양수가 터졌다”고 표현한 말을 AI가 “물을 버렸다”고 오역한 사례를 제시했다.
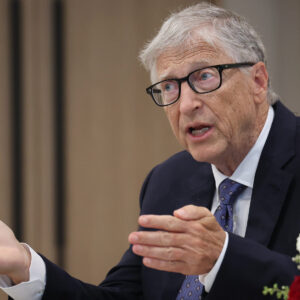
마크 수즈먼(Mark Suzman) 게이츠재단 최고경영자(CEO)는 AP와의 인터뷰에서 “AI 개발이 지금 당장 멈춘다고 해도 언어 데이터세트를 구축하고, 현재 이용할 수 있는 도구에 적용하는 작업은 계속해야 한다”고 말했다. 재단은 최근 AI를 활용해 저소득국의 보건·교육·농업 문제를 해결하는 데 2년간 10억 달러(약 1조3800억 원)를 투입하겠다고 밝힌 바 있다.
연합체는 ▲개방형 언어 데이터 기반 구축 ▲AI 언어 성능을 측정할 공통 평가체계 마련 ▲데이터를 실제 모델과 서비스로 전환 ▲개인정보와 동의, 데이터 주권을 보호하는 책임 있는 활용 등 네 가지 분야에 집중한다. 특정 기업만 활용하는 폐쇄형 데이터가 아니라 다양한 개발자와 지역사회가 사용할 수 있는 개방형 인프라를 구축한다는 구상이다.
참여기관인 구글은 인도 전 지역의 언어와 방언을 수집하는 ‘프로젝트 바니(Project Vaani)’를 통해 15만 시간 이상의 음성 데이터를 확보하고 있다. 모질라 데이터 컬렉티브는 기업이 인터넷에서 데이터를 일방적으로 수집하는 대신, 지역공동체가 이용 조건을 직접 설정해 언어·문화 데이터를 제공하는 체계를 개발하고 있다.
게이츠재단은 사무국을 두고 각 기관의 이행 상황을 관리하며, 지원이 부족한 언어와 지역에 추가 자원을 배분할 계획이다.
조유현 더나은미래 기자